
你有没有被“公网可达”这个指标骗过?Ping 一切正常,丢包为零,连通率 100%,但用户反馈“网站卡爆了”“加载页面像看幻灯片”。你愣住了:这不科学啊!
其实问题很可能出在你没注意到的跨境链路。公网能到,确实是“能走通”。但你有没有问过自己:路有多远?路上堵不堵?是不是走了绕路?是不是中间链路已近乎饱和?
如果你忽视这些隐藏的链路瓶颈,网站“慢”就会像幽灵一样困扰你,明明一切看似正常,用户体验却跌入谷底。
公网可达?只是网络连通性的最低标准
“公网可达”,简单理解就是:从用户到你服务器的 IP,可以打通。
但打通了就一定代表服务正常吗?显然不是。
打个比方:
有人给你寄了快递,你家门是开着的。但这包裹是不是绕了两倍的路、堵了半天才送到,你知道吗?“门开着”,只代表“理论上能送达”,跟“送达体验”关系不大。
公网可达就像那扇门,而链路质量才是决定这趟路好不好走的关键。
跨境链路到底在哪卡住了?
如果你的客户是跨境用户(比如东南亚、日本、北美),跨境链路就是你的命脉。
但真实的网络链路,从源站到用户,中间经过的出口路由、海底光缆、国际骨干网、回程路由……复杂到超出你的想象。
常见瓶颈可能出现在:
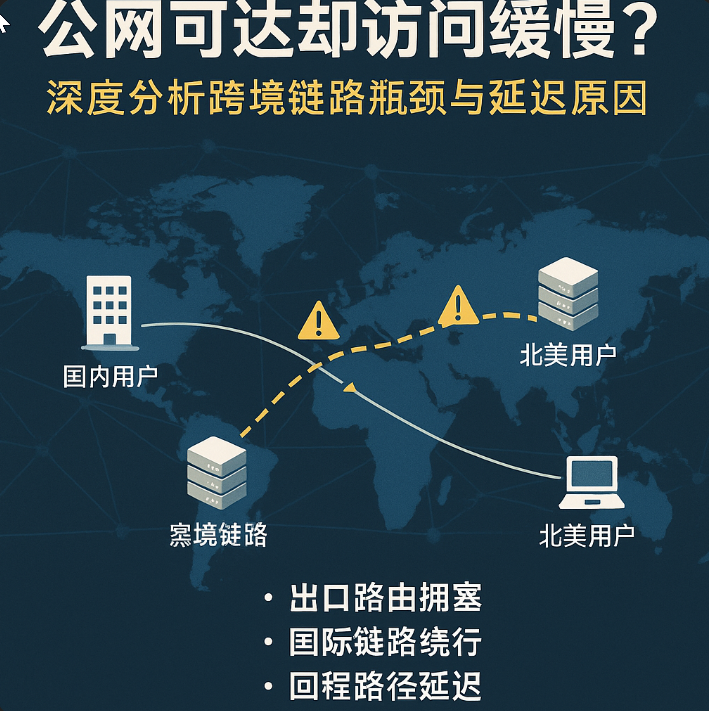
出口路由
从中国大陆出口到国际骨干网的路由策略不合理,或带宽不足,造成请求在出口排队,延迟暴涨。国际骨干网络段
海底光缆和国际互联带宽饱和,特别是在高峰时段,导致 TCP 重传增多、抖动变大。回程路由
服务器返回用户的数据包,走的是完全不同的路径,某个回程链路断流或限速,导致页面加载慢得吓人。运营商策略路由
不同运营商对国际流量有自己的路由规则,可能会优先走成本更低的链路,而不是最快的路径。
你依赖的“全国平均”,不过是错觉
很多人看着监控后台“全国平均 RTT 60ms”,就安心了。可如果你关注各地细分指标,尤其是跨境线路,你会发现:
国内访问没问题;
香港节点访问爆炸;
新加坡节点延迟超 300ms;
美国节点严重丢包。
这意味着什么?
你的国内链路表现优秀,但出口一塌糊涂,公网“通”只是掩盖了跨境链路的真实问题。
如何发现这些隐藏的跨境链路瓶颈?
1. 多点分布式探测
依靠单点探测?只测国内?你就永远不知道海外用户发生了什么。
部署多地探测节点(香港、新加坡、东京、洛杉矶等);
监测每个节点到服务器的实际 RTT、丢包率、TCP 建立耗时;
对比不同出口方向的链路质量,发现瓶颈。
2. MTR / Traceroute 路由路径跟踪
使用 MTR 或 Traceroute 工具,从不同地域发起探测,跟踪中间节点的 RTT 和丢包情况。这样,你能清楚看到请求在哪个路由节点开始恶化。
3. 结合应用层指标
仅有 Ping 和 TCP 监测远远不够。你还应该关注:
TLS 握手耗时(如果用 HTTPS);
HTTP TTFB(首字节时间);
内容加载总耗时;
这些才是真实影响用户体验的指标。
跨境访问慢的真实案例
有个国内的企业网站,主打海外客户。客服天天收到抱怨:“美国访问你们官网非常卡”,但他们后台 Ping 值显示 80ms,很正常。
为什么?
他们的出口路由走的是默认 BGP,出口流量绕道法国,再转回美国东海岸,物理距离增加了一倍,导致回程路由延迟拉爆。而且出口骨干带宽在高峰时段过饱和,TCP 抖动严重。
他们后来接入了多出口国际专线,并优化了 BGP 策略,才解决了这个问题。
如何优化跨境链路?
接入多出口 BGP:避免单一运营商出口堵塞;
使用专线或高质量国际 CDN:优先走质量高的国际链路;
优化回程路由:监测回程链路,避免路径绕行;
实时监控:通过多地探测监控工具,动态掌握链路状态。
你的“公网可达”,只是最低标准
链路质量才是真实问题。
公网可达,却访问卡顿?你该考虑链路是不是早就被堵死在跨境出口了。
 豫公网安备41160202000677

